免费 AI 口型同步视频生成器

上传一段人物说话的视频和一条新的配音,AI 会重新驱动嘴部动作,让每个字都对上口型。可以把视频配成另一种语言、替换某句台词,或修复音画不同步,支持 3 到 60 秒的片段。 无需重拍,也无需配音演员出镜。
西班牙语配音
日语配音
法语配音
葡萄牙语配音
你的视频
MP4 或 MOV,最长 60 秒、50MB 以内,画面里要有一张清晰的正脸。
语音(可选)
MP3、WAV 或 M4A,3–60 秒。还没有音频?下一步输入台词、选个声音就能生成。
上传文件即表示你同意 GoEnhance 的服务条款和隐私政策

如何用 AI 给视频做口型同步

01

上传你的视频

上传 MP4 或 MOV 片段,最长 60 秒、不超过 50MB,画面中要有一张清晰可见、大致正对镜头的人脸。

02

添加新的声音

上传音频文件,或输入文案并选择一种声音来生成语音。任何口语语言都可以。

03

生成并下载

选择 540p 或 720p,点击「生成」。几分钟后即可拿到口型同步后的 MP4。如果音频比视频长,请开启循环模式。

口型同步与说话头像对比

AI 口型同步AI 说话头像
起始素材一段人物说话的视频一张照片、绘画或角色图片
AI 做什么重新驱动嘴部动作以匹配新音频,其余画面保持原样让静态图片中的脸部和头部动起来,说出你的音频
最适合把视频配成其他语言、替换台词、修复音画不同步把照片变成主持人、VTuber、播客主播或会说话的宠物
片段时长3–60 秒3–60 秒
每秒费用2–3 代币3–8 代币,取决于模型和分辨率

口型同步模型与价格

模型输出每秒费用说明
v2(默认)540p2 代币默认模型
v2(默认)720p3 代币输出分辨率更高
v1—2 代币画面中有多人时,可以选择同步哪张脸

AI 口型同步视频生成器的核心功能

音画完美同步

新音频的每个音节都会逐帧驱动嘴部动作,让配音后的片段看起来就像原本就是这样录的。这里把一位厨师的英文开场白重新配成了法语。

多语言 AI 口型同步

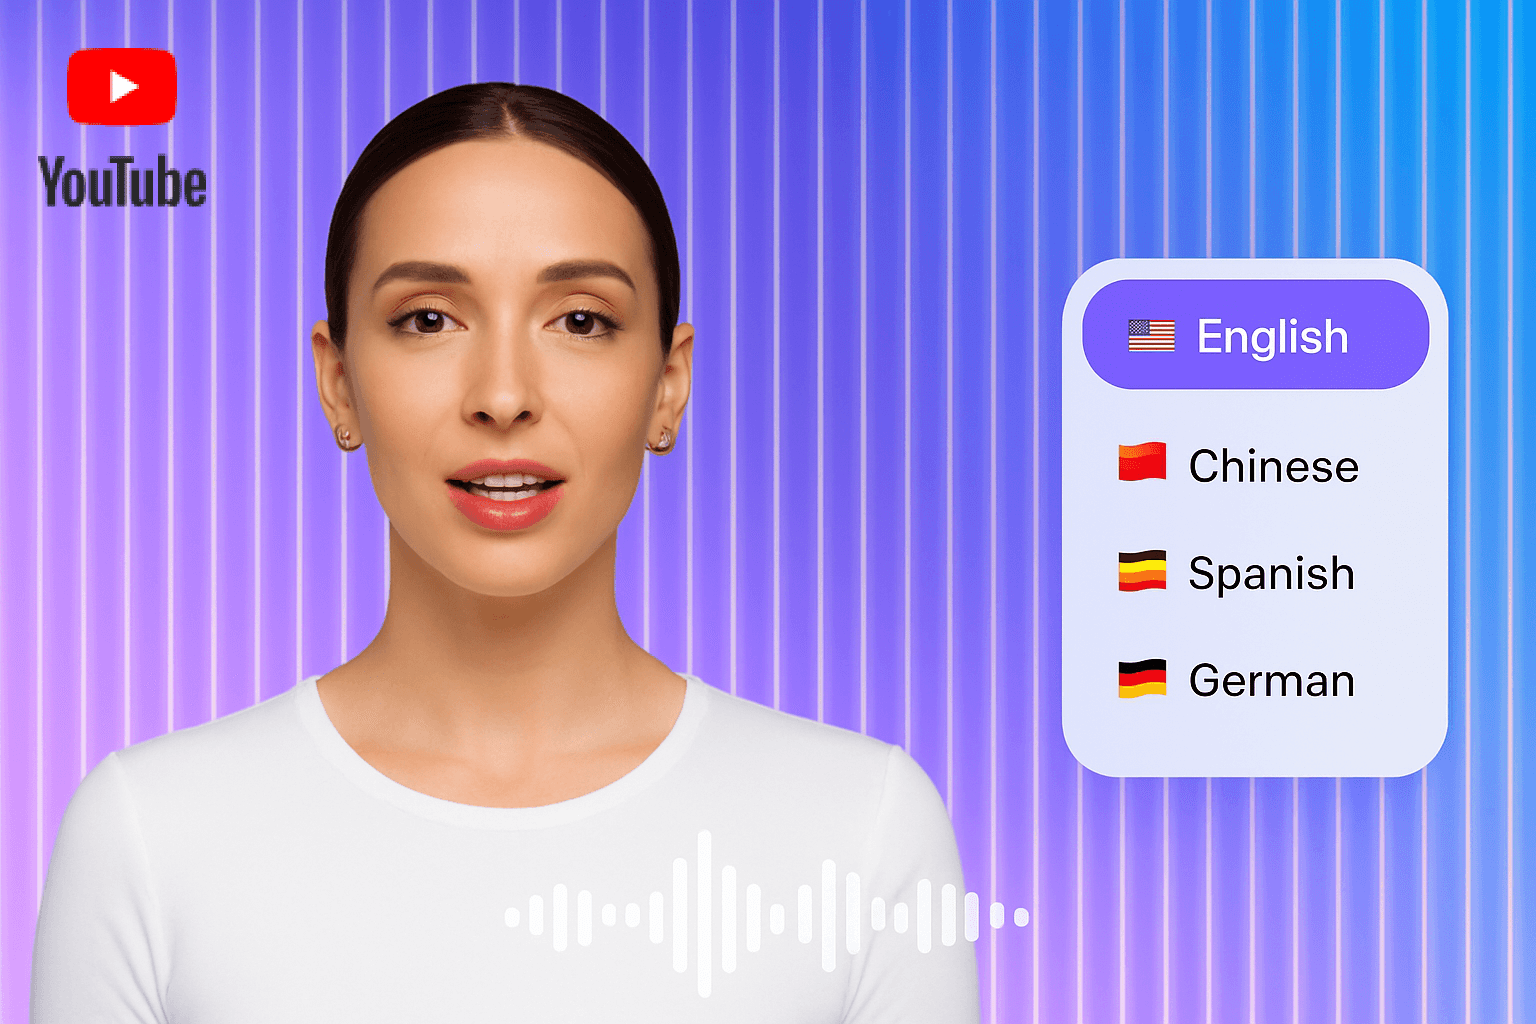
一段视频想配成多少种语言都可以。同一位主持人先说原版英语,再说西班牙语和日语,嘴型与每种语言都对得上。

自然 & 逼真的口型动作

只重新驱动嘴部,原始画面中的头部动作、表情和背景都保持不变。非常适合营销视频、课程和社交媒体短片。

AI 口型同步常见问题

什么是 AI 口型同步?

AI 口型同步会读取一段人物说话的视频和一条新的音轨,然后重新驱动嘴部动作,让它与新的台词对上。GoEnhance 会让画面的其余部分保持拍摄时的样子。

视频最长可以多长?

每次口型同步的时长为 3 到 60 秒。可上传不超过 50MB 的 MP4 或 MOV 文件。音频文件同样最长 60 秒。

如果音频比视频长会怎样?

默认情况下,结果时长以两者中较短的为准。开启循环模式后,视频会来回播放,以容纳完整的音频。

口型同步支持哪些语言?

任何口语语言都支持。嘴部动作跟随音频中的发音,因此英语、西班牙语、日语、法语、葡萄牙语等都适用。本页的示例都是从英语配音而来。

AI 口型同步怎么收费?

使用默认的 v2 模型,540p 每秒 2 代币,720p 每秒 3 代币,因此一段 20 秒的 540p 片段需要 40 代币。

口型同步和说话头像有什么区别?

口型同步从视频出发,只改变嘴部。说话头像从一张照片出发,让整张脸动起来。想给现有视频配音或修正时用口型同步,手里只有一张图片时用说话头像。

什么样的视频效果最好?

画面中有一张清晰可见、光线充足、大致正对镜头的人脸,音频中人声清晰、背景噪音少。如果画面中有多人,请使用 v1 模型选择要同步的那张脸。

立即创建你的口型同步视频!

省去拍摄演员或排练台词的麻烦。借助我们的 AI 口型同步工具,您可以在视频中生成逼真、节奏精准的嘴部动作。只需上传 MP4 视频,并添加预录音轨或用文本生成语音 —— 即可快速获得可直接投入制作的口型同步 MP4 视频。

为你的视频做口型同步